Claude Fable 5.1とは|知能指数66で首位、実質コスト最大45%減
更新: 2026.09.01
新しいフラッグシップモデルが出ると、たいてい「性能は上がったが単価も上がった」という話になります。今回は少し違いました。
Anthropicは2026年9月1日、Claude Fable 5.1とClaude Mythos 5.1を公開しました。Fable 5.1は同社が「最上位クラス」と位置づけるモデルで、長時間かかる調査やコーディングを任せる用途を想定しています。
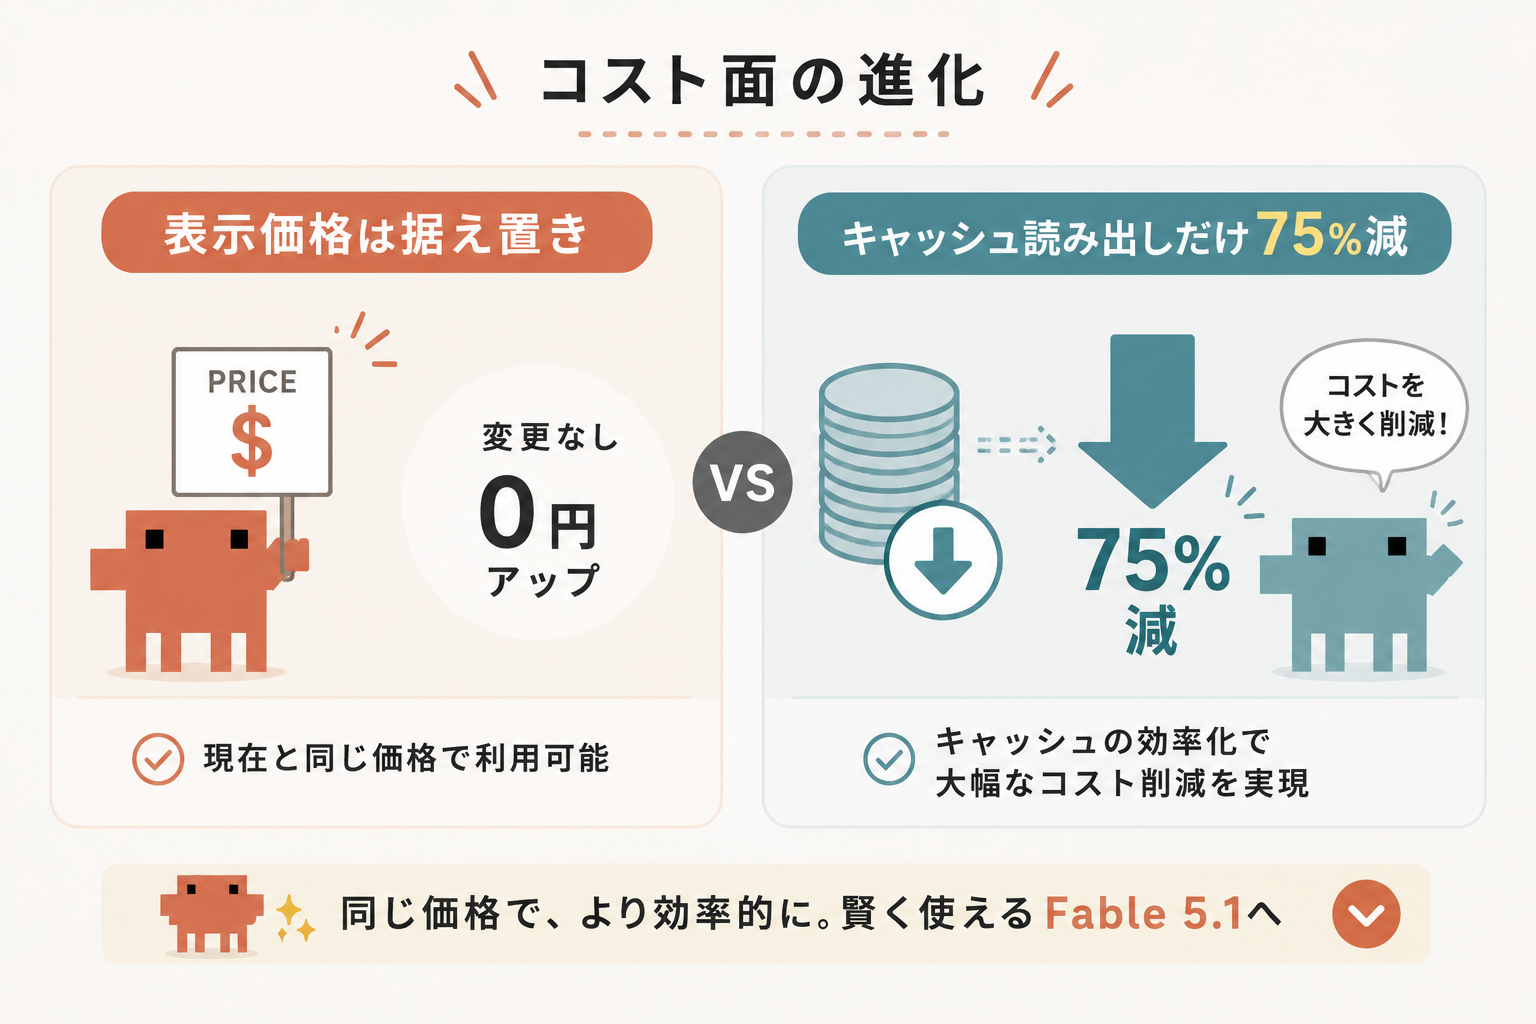
注目したいのは知能スコアより先に、運用コストの下がり方です。入力100万トークンあたり10ドル、出力50万トークンあたり50ドルという表示価格はFable 5と同じ据え置き。そのうえでキャッシュ読み出しの単価だけが100万トークンあたり0.25ドルへ下がりました。Fable 5比で75%の削減です(2026年9月2日、Anthropic公式アナウンスで確認。1ドル=150円なら約37.5円)。
Anthropicの試算では、この変更で一般的な使い方の総コストが約25%、エージェント的に何度も履歴を読み返す使い方では最大約45%下がるとされています。
つまり「賢くなったから高くなった」ではなく、「賢くなって、使い方によっては安くなった」。この記事では、公式発表とArtificial Analysisの公開データを2026年9月2日時点で照合し、Fable 5.1で実際に何が変わったのかを整理します。
目次
まず変更点を3つだけ
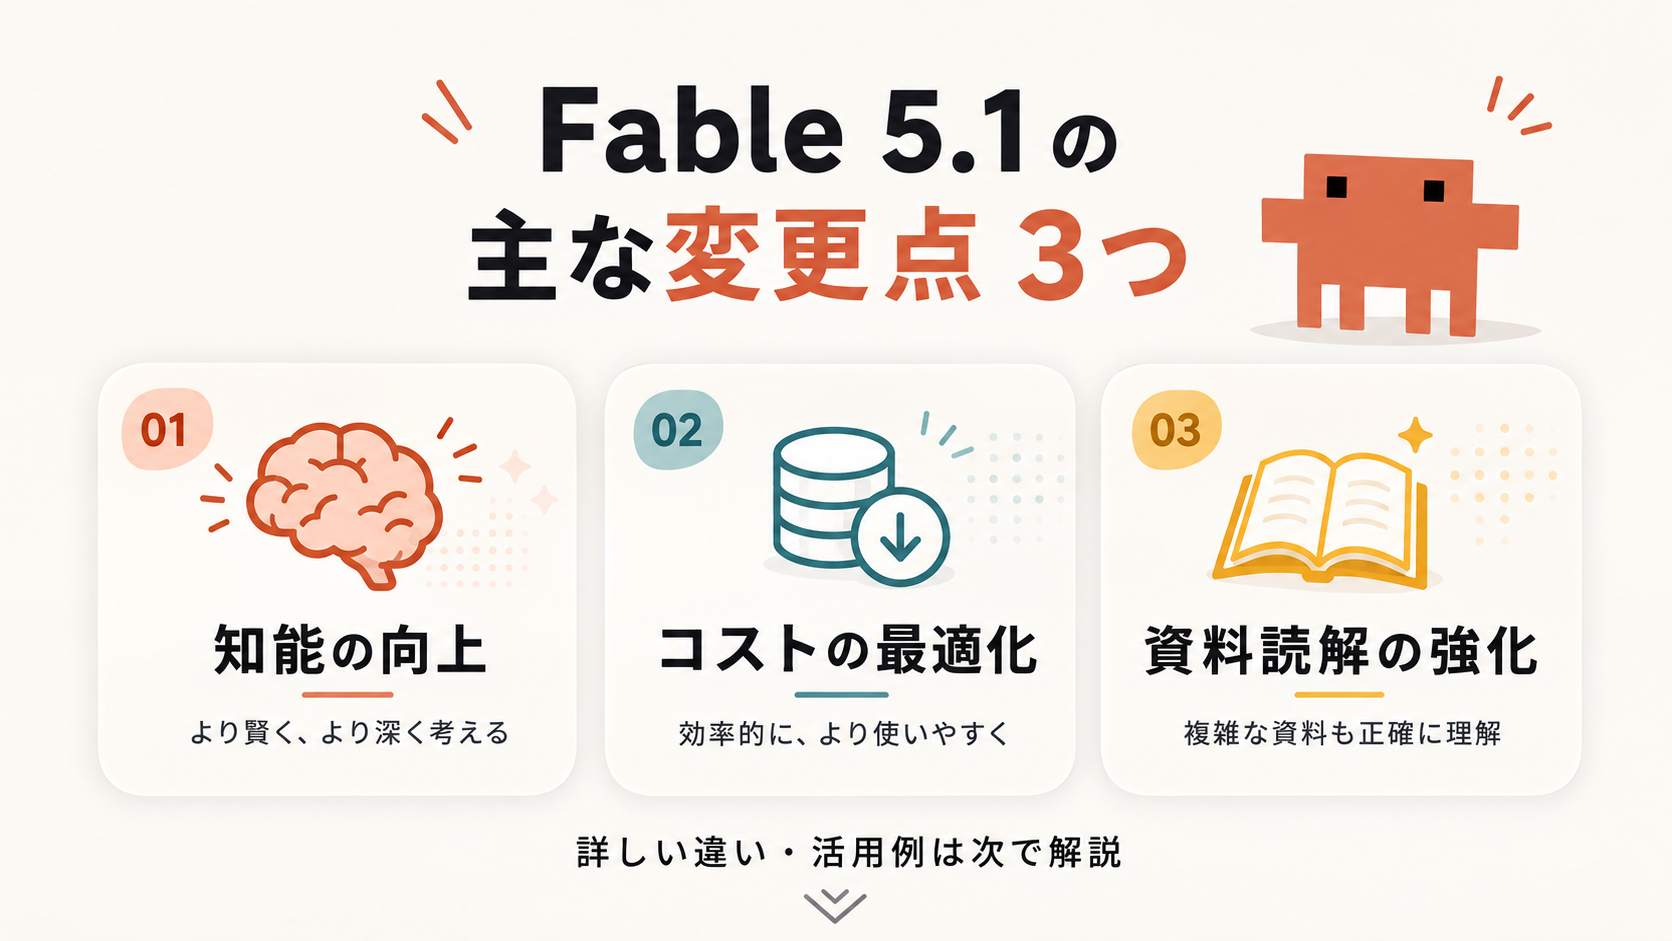
細かいベンチマークに入る前に、全体像を共有します。Fable 5からの変化は、大きく次の3点です。
変わった点 | 具体的にどうなったか | 効いてくる場面 |
|---|---|---|
知能 | Artificial AnalysisのIntelligence Indexで66。単独首位で、Opus 5(63)を3ポイント上回る | 難しい推論・長い工程のタスク |
コスト | 表示価格は据え置き。キャッシュ読み出しが75%減、実質コストは25〜45%減 | 長い履歴を何度も読み返すエージェント用途 |
資料の読解 | ファイルやPDFに埋め込まれた図・グラフ・表を理解できるように | 財務・法務・分析・設計など資料が重い仕事 |
3点目は地味ですが、実務では大きい変化です。これまでは「PDFの中の折れ線グラフ」を渡しても数値を取りこぼしがちでした。Fable 5.1はそこを読めるとされています。
以下、順に見ていきます。
Artificial Analysisの評価——知能指数で単独トップ
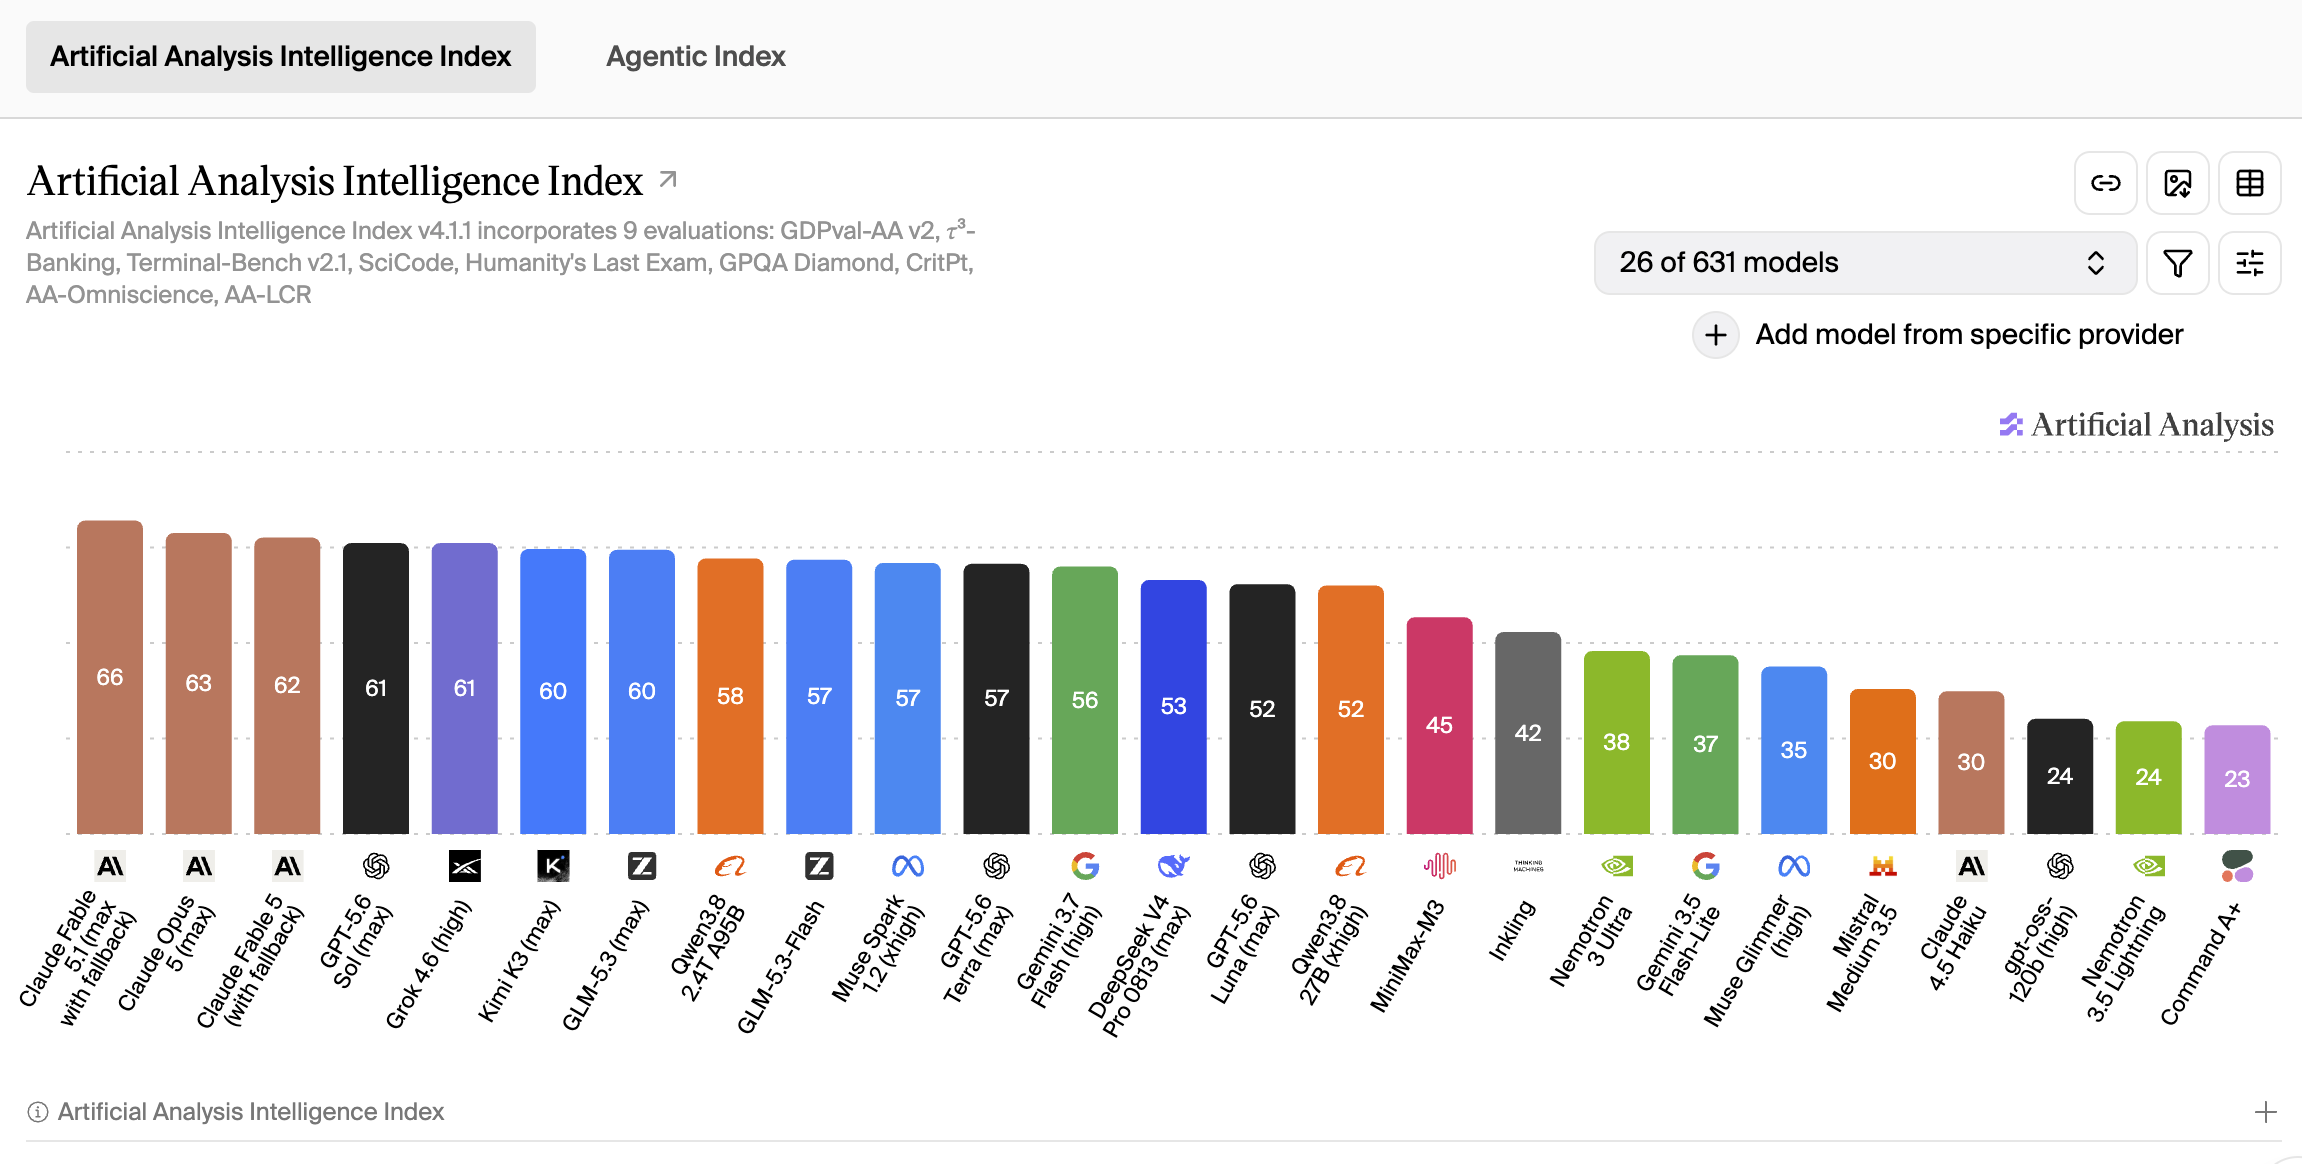
第三者ベンチマークのArtificial Analysisは、複数の推論・コーディング・知識テストを1つのスコアにまとめた「Intelligence Index」を公開しています。
2026年9月2日時点で、Claude Fable 5.1(最大effort)のスコアは66。これは同指数の単独首位で、Opus 5(63)を3ポイント上回ります。主な比較対象は次のとおりです(いずれも2026年9月2日、Artificial Analysisの公開値)。
モデル | Intelligence Index |
|---|---|
Claude Fable 5.1 | 66 |
Claude Opus 5 | 63 |
GPT-5.6 Sol | 61 |
Grok 4.6(high) | 61 |
Kimi K3(max) | 60 |
Gemini 3.7 Flash(high) | 56 |
Anthropic自身の従来フラッグシップであるOpus 5を3ポイント、OpenAIとxAIの現行モデルを5ポイント引き離しています。単一指標なので過信は禁物ですが、「現時点で最も高いスコアを持つ汎用モデル」という位置づけは押さえておいてよいでしょう。
なお、このスコアは「max effort」での測定です。Fable 5.1にはlow/medium/high/x-high/maxという5段階の思考の深さ設定があり、Anthropicによれば低〜中の設定でもFable 5と同等以上、高い設定で大きく伸びる、とされています。常に最大で回す必要はありません。
ベンチマークで見る「エージェント性能」の伸び
Anthropicが公式発表で示した数値のうち、伸び幅が大きいのはエージェント系のテストです。人間が張り付かずにモデルへ作業を任せる場面での実力に近い指標だと考えてください(すべて2026年9月2日、公式アナウンスで確認)。
- 科学研究のエージェントタスク(Terminal-Bench-Science 0.1): Fable 5.1が52.6%。Fable 5の24.7%から2倍以上。Opus 5は29.0%
- コーディングのエージェントタスク(Terminal-Bench 4.0): Fable 5.1が55.8%。Fable 5は42.0%、Opus 5は52.3%
- 業務自動化(AutomationBench): Fable 5.1が31.4%。Fable 5は17.1%
- コンピュータ操作(OSWorld 2.0・部分達成): Fable 5.1が77.9%。Fable 5は72.9%
- ツールなしの多分野推論(Humanity's Last Exam): Fable 5.1が60.9%。Fable 5は57.8%
導入企業のコメントも、この「長時間の作業に任せられる」方向に寄っています。Anthropicの発表では、開発エージェントのCognition(Devin)が「公開初日にOpus 5のトラフィックをFable 5.1へ移す」と述べ、理由を「同等の性能をより低いコストで出せるから」としています。ShopifyやMongoDBも、監視なしで長時間走らせる用途での改善に言及しています。
知識のカットオフも更新され、Fable 5より5か月新しい2026年6月までの情報を持ちます。
料金と、どこで使うか
改めて料金を整理します(2026年9月2日、公式アナウンスで確認。円換算は1ドル=150円で試算、為替は変動します)。
項目 | Fable 5.1 | 補足 |
|---|---|---|
入力 | 100万トークンあたり10ドル(約1,500円) | Fable 5から据え置き |
出力 | 100万トークンあたり50ドル(約7,500円) | Fable 5から据え置き |
キャッシュ読み出し | 100万トークンあたり0.25ドル(約37.5円) | Fable 5比で75%減 |
コンテキスト長 | 100万トークン | 約A4・1,500ページ相当 |
API識別子 |
| ─ |
キャッシュ読み出しが効くのは、同じ長い前提(システムプロンプトや資料一式)を何度も読ませるケースです。1回のチャットで終わる用途では体感差は小さく、逆にエージェントで何十ターンも履歴を積む用途では、ここのコスト差がそのまま請求額に出ます。
利用できる場所は幅広く、Claude API、Claude Code、Claude Enterprise、Amazon Web Services、Google Cloud、Microsoft Azureで2026年9月1日から提供されています。Claude CodeではデフォルトのeffortがHigh、Claude.aiではMediumに設定されています。
Mythos 5.1との関係
Fable 5.1とMythos 5.1は「同じモデルで、安全対策の強さが違う」だけの関係です。
一般提供されるのがFable 5.1。Mythos 5.1は、サイバーセキュリティや生命科学の専門業務向けに安全対策を緩めた版で、審査を通った組織(現状は米国のみ)だけが使えます。通常の開発や調査でMythos 5.1を意識する必要はありません。
一点だけ実務に関わる変更として、サイバーセキュリティ関連の安全フィルターの「誤検知」が前版比で約60%減ったとAnthropicは説明しています。防御目的の脆弱性調査で正当なリクエストが弾かれる頻度は下がる見込みです。
まず何をすればいいか
Fable 5.1の位置づけは「現時点で最も知能スコアが高く、長時間のエージェント作業では実質コストがむしろ下がったフラッグシップ」です。
すでにClaude API経由でOpus 5やFable 5を使っているなら、まずは負荷の高い1タスクだけモデル識別子を claude-fable-5-1 に差し替え、effortをlowかmediumから試すのが安全です。表示価格は同じなので、切り替えのリスクはほぼコンテキストキャッシュの再構築コストだけ。そこで出力の質とキャッシュ読み出しの請求額を見てから、常用に上げるか判断してください。
よくある質問(FAQ)
Q.Claude Fable 5.1はFable 5から何が変わりましたか?
A.大きく3点です。Artificial AnalysisのIntelligence Indexが66へ上がり単独首位になったこと、表示価格は据え置きのままキャッシュ読み出し単価が75%下がったこと、ファイルやPDFに埋め込まれた図・グラフ・表を読めるようになったことです。知識のカットオフも2026年6月まで更新されました(2026年9月2日、公式アナウンスで確認)。
Q.Claude Fable 5.1の料金はいくらですか?
A.入力が100万トークンあたり10ドル、出力が100万トークンあたり50ドルで、Fable 5から据え置きです。変わったのはキャッシュ読み出しで、100万トークンあたり0.25ドルとFable 5比で75%下がりました。Anthropicの試算では一般的な用途で総コスト約25%減、エージェント用途で最大約45%減とされています(2026年9月2日、公式アナウンスで確認)。
Q.Claude Fable 5.1とMythos 5.1は何が違いますか?
A.同じモデルで、安全対策の強さだけが異なります。一般提供されるのがFable 5.1、審査を通った組織(現状は米国のみ)向けにサイバーセキュリティや生命科学の安全対策を緩めた版がMythos 5.1です。通常の開発や調査でMythos 5.1を意識する必要はありません。
その他のご不明点がある場合は、お問い合わせページからご連絡ください。